MySQL 迁移同步到 PolarDB Oracle
创建 MySQL 到 PolarDB Oracle 复制任务时,控制台提供结构复制、全量复制和增量复制选项。本文按当前页面中的结构复制加全量复制流程说明。
前提条件
已将 MySQL 源数据源和 PolarDB Oracle 目标数据源添加至 NineData,且目标数据源状态为可用。如何添加,请参见添加数据源。
在创建复制任务时,目标数据源类型选择 PolarDB(兼容Oracle)。
复制任务需要访问源数据源和目标数据源。具体账号权限以创建任务时的预检查结果为准。
使用限制
- 当前链路的全量复制选项右侧显示周期性全量复制开关;是否启用以及后续参数以当前页面显示为准。
数据类型映射
以下映射范围为 MySQL 9.5.0 到 PolarDB Oracle 兼容版 V2.0.14.18.37.0,适用于结构复制加全量复制。右列表示目标端目录中记录的列类型。本表仅说明列类型,不描述数据值转换、符号范围、时区语义或自增属性。各测试批次用于复制流程的控制列均不属于下表的类型项。
源类型名称和语法依据 MySQL 9.5 Reference Manual:Data Types、Numeric Data Type Syntax、Using Data Types from Other Database Engines 和 String Data Type Syntax;空间类型名称参见 Spatial Data Types。
| MySQL 源列类型 | PolarDB Oracle 目标列类型 |
|---|---|
SERIAL | bigint |
TINYINT | smallint |
SMALLINT | smallint |
MEDIUMINT | integer |
INT | integer |
INTEGER | integer |
TINYINT UNSIGNED | smallint |
SMALLINT UNSIGNED | integer |
MEDIUMINT UNSIGNED | integer |
INT UNSIGNED | bigint |
BIGINT UNSIGNED | numeric(22,0) |
BIGINT | bigint |
INT1 | smallint |
INT2 | smallint |
INT3 | integer |
INT4 | integer |
INT8 | bigint |
MIDDLEINT | integer |
DECIMAL(30,10) | numeric(30,10) |
DECIMAL(65,30) | numeric(65,30) |
DECIMAL(65,0) | numeric(65,0) |
DEC(30,10) | numeric(30,10) |
NUMERIC(30,10) | numeric(30,10) |
FIXED(30,10) | numeric(30,10) |
FLOAT | real |
FLOAT(24) | real |
FLOAT(25) | double precision |
FLOAT4 | real |
REAL | double precision |
DOUBLE | double precision |
FLOAT8 | double precision |
DOUBLE PRECISION | double precision |
BIT(1) | bit(1) |
BIT(16) | bit(16) |
BIT(64) | bit(64) |
BOOL | smallint |
BOOLEAN | smallint |
DATE | date |
TIME(6) | time(6) without time zone |
TIME(0) | time(6) without time zone |
DATETIME(6) | timestamp(6) without time zone |
DATETIME(0) | timestamp(6) without time zone |
TIMESTAMP(6) | timestamp(6) with time zone |
TIMESTAMP(0) | timestamp(6) with time zone |
YEAR | smallint |
CHAR(10) | character(10) |
CHAR(255) | character(255) |
CHARACTER(10) | character(10) |
NATIONAL CHAR(10) | character(10) |
NCHAR(10) | character(10) |
CHAR BYTE | bytea |
VARCHAR(64) | character varying(64) |
VARCHAR(255) | character varying(255) |
CHARACTER VARYING(64) | character varying(64) |
NATIONAL VARCHAR(64) | character varying(64) |
NVARCHAR(64) | character varying(64) |
NATIONAL CHAR VARYING(64) | character varying(64) |
NCHAR VARCHAR(64) | character varying(64) |
BINARY(8) | bytea |
BINARY(255) | bytea |
VARBINARY(64) | bytea |
VARBINARY(255) | bytea |
LONG VARBINARY | bytea |
TINYBLOB | bytea |
BLOB | bytea |
MEDIUMBLOB | bytea |
LONGBLOB | bytea |
TINYTEXT | text |
TEXT | text |
MEDIUMTEXT | text |
LONGTEXT | text |
LONG VARCHAR | text |
LONG | text |
ENUM('red','green','blue') | character varying(255) |
SET('a','b') | character varying(255) |
GEOMETRY | character varying(255) |
POINT | character varying(255) |
LINESTRING | character varying(255) |
POLYGON | character varying(255) |
MULTIPOINT | character varying(255) |
MULTILINESTRING | character varying(255) |
MULTIPOLYGON | character varying(255) |
GEOMETRYCOLLECTION | character varying(255) |
JSON | json |
VECTOR(3) | character varying(204) |
目标目录对本次测试中的 TIME(0)/TIME(6)、DATETIME(0)/DATETIME(6) 和 TIMESTAMP(0)/TIMESTAMP(6) 均记录 datetime_precision=6,因此右列明确列出目标精度。
本次 MySQL 会话的 SQL mode 为 STRICT_TRANS_TABLES;该环境中 REAL 源列在 MySQL 目录中解析为 DOUBLE,复制后的目标目录类型为 double precision。其他 MySQL 版本、PolarDB 版本及参数组合未由此表覆盖。
操作步骤
登录 NineData 控制台。
在左侧导航栏单击数据复制 > 数据复制。
在数据复制页面,单击右上角的创建复制。
在数据源与目标页签,按照下表进行配置,并单击下一步。
参数 说明 任务名称 输入数据同步任务的名称,为了方便后续查找和管理,请尽量使用有意义的名称。最多支持 64 个字符。 源数据源 同步对象所在的数据源。 目标数据源 接收同步对象的数据源。 目标数据库 选择将数据同步到目标的哪个数据库。 目标对象命名规则 选择对象名称从源端迁移到目标端后的大小写转换规则。 - 全部转小写:无论源端的命名规则如何,目标端的命名规则全部为小写。
- 保持与源一致:沿用源端的命名规则。
- 全部转大写:无论源端的命名规则如何,目标端的命名规则全部为大写。
复制类型 选择复制类型。 - 结构复制:只同步源数据源的库表结构,不同步数据。
- 全量复制:同步源数据源的所有对象和数据,即全量数据复制。右侧的开关为周期性全量复制的开关,更多信息,请参见周期性全量复制。
- 增量复制:在全量同步完成后,基于源数据源的日志进行增量同步。
 图标为增量操作类型配置,可以根据需求取消勾选某一些操作类型,取消勾选后,这些操作会在增量同步中被忽略。
增量开始时间 复制类型仅为增量复制时需要选择。 - 从启动时间开始:以当前复制任务开始时间为基准,进行增量复制。
- 自定义时间:选择增量复制开始的时间点,您可以根据您的业务所在地域按需选择时区。如果将时间点配置为当前复制任务开始前,则如果该时间段内有 DDL 操作,复制任务将失败。
复制规格 复制任务的规格,规格越大复制的速率越高,将鼠标悬浮于  图标上即可查看每个规格对应的速率和配置信息。如果先配置数据复制任务再购买资源,可以在此选择需要的规格;如果先购买资源再配置任务,系统会选中购买资源时指定的规格,且无法在任务配置中变更。
目标库同名对象处理策略(选中结构复制时需要选择) - 预检查报错并停止任务:预检查阶段检测到同名表时,停止任务。
- 跳过并继续任务:预检查阶段检测到同名表时,发送提示并继续任务。 结构复制时,忽略该同名表。如果您同时进行了数据复制,则数据会在同名表中追加,而不会覆盖原有数据。
- 删除对象并重建:预检查阶段检测到同名表时,发送提示并继续任务。结构复制时,删除目标库同名表,并基于源库重新复制表结构。如果您同时进行了数据复制,则数据会在表结构复制完成后写入。
目标表存量数据处理策略(选中全量复制时需要选择) - 预检查报错并停止任务:预检查阶段检测到目标表中存在数据时,停止任务。
- 忽略目标存量数据,追加写入:预检查阶段检测到目标表中存在数据时,忽略该部分数据,追加写入其他数据。
- 清空目标存量数据,重新写入:预检查阶段检测到目标表中存在数据时,删除该部分数据,重新写入。
目标表增量数据冲突处理策略(选中增量复制时需要选择) - 运行时报错:增量复制过程中遇到目标数据已存在则报错,等待人工介入处理。
- 不更新目标数据:增量复制过程中遇到目标数据已存在则不写入,并继续后续任务。
- 更新目标数据:增量复制过程中遇到目标数据已存在则覆盖写入目标数据。
在选择复制对象页签,配置下列参数,然后单击下一步。
参数 说明 复制对象 选择需要复制的内容,您可以选择全部实例复制源库所有内容,也可以选择自定义对象,在源对象列表中选中需要复制的内容,单击>添加到右侧目标对象列表。 如果您需要创建多条相同复制对象的复制链路,可以创建一个配置文件,在新建任务的时候导入即可。单击右上角的导入配置,再单击下载模板,将配置文件模版下载到本地,编辑完成后单击上传文件上传该配置文件即可实现批量导入。字段和示例请参见导入复制对象配置模板。配置文件说明:
参数 说明 示例 source_table_name需同步的源表名。填写源数据源中实际存在的表名。 example_tbl_nametarget_table_name接收同步对象的目标表名。 example_tbl_namesource_database_name需同步的对象所在的源库名。 test_dbtarget_database_name接收同步对象的目标库名。 test_db_bakcolumn_list需要同步的字段列表。 ["col1", "clo2", "col3"]extra_configuration额外配置的 JSON 字符串。 column_rules用于配置字段映射与取值规则,其中column_name为源列名,target_column_name为目标列名,target_column_type为目标列类型,column_value为字段值;filter_condition用于配置行级过滤条件。{"extra_config": {"column_rules": [...]}}提示以下 JSON 表示下载的 Excel 模板中的两行示例数据。实际上传时,请保留 Excel 模板的列名,并将
extra_configuration单元格填写为 JSON 字符串;以下代码块不是可直接上传的 JSON 文件。[
{
"source_table_name": "example_tbl_name",
"target_table_name": "example_tbl_name",
"source_database_name": "test_db",
"target_database_name": "test_db_bak",
"column_list": ["col1", "clo2", "col3"],
"extra_configuration": {
"extra_config": {
"column_rules": [
{
"column_name": "example_column_name",
"target_column_name": "example_target_column_name",
"target_column_type": "int",
"column_value": "current_timestamp()"
},
{
"column_name": "example_column_name",
"target_column_name": "example_target_column_name",
"target_column_type": "int"
}
],
"filter_condition": "example_condition_expression"
}
}
},
{
"source_table_name": "example_order_tbl",
"target_table_name": "example_order_tbl",
"source_database_name": "test_db",
"target_database_name": "test_db_bak",
"column_list": ["col1", "clo2", "col3"],
"extra_configuration": {
"extra_config": {
"column_rules": [
{
"column_name": "example_column_name",
"target_column_name": "example_target_column_name",
"target_column_type": "int",
"column_value": "current_timestamp()"
},
{
"column_name": "example_column_name",
"target_column_name": "example_target_column_name",
"target_column_type": "int"
}
],
"filter_condition": "example_condition_expression"
}
}
}
]在配置映射页签,根据所选的复制类型选择不同操作,然后单击保存并预检查。如果在配置映射阶段,源和目标数据源中有更新,可以单击页面右上角的刷新元数据按钮,重新获取源和目标数据源的信息。
包含结构复制:配置目标表同步到目标数据源之后的表名。
不包含结构复制:系统默认选择目标数据源中的同名数据库,如果不存在,则需要手动选择目标库。目标库中的表名、列名需要和同步对象一致。如果不一致,您也可以手动进行表名和列名的映射。
您还可以进行如下操作:
- 单击页面右侧的映射与过滤,自定义列名同步到目标数据源之后的名称。
- 在映射与过滤页面,在数据过滤条件下方的文本框中输入比较表达式作为过滤条件,仅符合过滤条件的数据会同步到目标数据源。例如,将过滤条件设置为
emp_no>=10005,则 emp_no 列中小于 10005 的数据均不会同步到目标数据源。 - 单击"目标表名"右侧的
 图标,可搜索表名,并替换成目标名称。
- 在右上角的搜索表文本框中输入表名以快速定位到目标表。
- 单击右上角的批量配置,可以批量定义通用规则(如表名、字段名大小写转换、前后缀添加、替换等),实现对大量表和字段的统一映射配置。
- 单击 Object Owner 右侧的下拉菜单,可以指定对象的所有者。下拉菜单的可选项和默认值以当前页面显示为准。
- 单击页面中的设置 Tablespace,可为目标数据源中的表和索引分别指定所属的 Tablespace,用于控制对象在目标库中的物理存储位置;若不进行设置,则默认使用目标数据库用户的默认 Tablespace。
在预检查页签,等待系统完成预检查,预检查通过后,单击启动任务。
您可以勾选开启数据一致性对比。在同步任务完成后,自动开启基于源数据源的数据一致性对比,保证两端数据一致。根据您选择的复制类型,开启数据一致性对比的启动时机如下:
- 结构复制:结构复制完成后启动。
- 结构复制+全量复制:全量复制完成后启动。
- 全量复制:全量复制完成后启动。
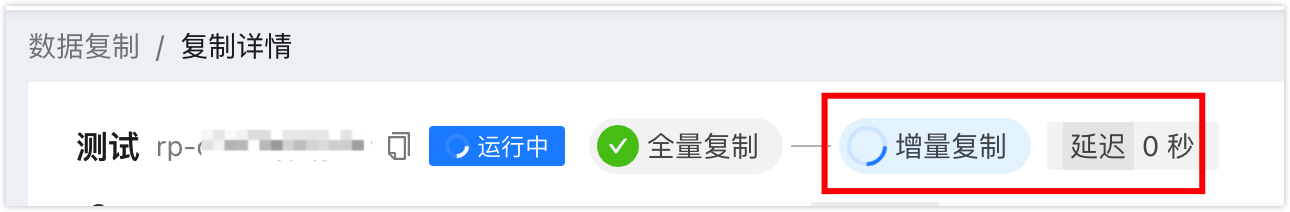
- 结构复制+全量复制+增量复制、增量复制:当增量数据首次和源数据源一致且延迟为 0 秒时启动。您可以单击查看详情,在复制详情页面中查看同步延迟。
如果预检查未通过,需要单击目标检查项右侧操作列的详情,排查失败的原因,手动修复后单击重新检查重新执行预检查,直到通过。
检查结果为警告的检查项,可视具体情况修复或忽略。
在启动任务页面,提示启动成功,同步任务开始运行。此时您可以进行如下操作:
单击查看详情查看同步任务各个阶段的执行情况。
- 单击返回列表可以返回数据复制任务列表页面。
修改增量同步位点
对于复制类型中包含增量复制且任务详情提供位点管理的任务,可以查看并修改同步位点。可用的位点类型和输入格式由当前数据源及复制链路决定,以页面显示为准;如果位点显示为 - 或位点类型没有可选项,则当前任务没有可供修改的位点。
该功能用于特定运维场景:重新指定增量任务的日志读取位置或同步写入位置。读取位点控制任务从源端哪个位置继续读取,写入位点控制任务从哪个位置继续处理同步写入;提交后任务会暂停并重新启动,使新的位点生效。
在复制任务列表中,单击目标任务的任务 ID,进入任务详情。
单击增量复制页签,然后单击同步位点管理,查看当前的读取位点和写入位点。
单击修改位点。在位点类型中选择要调整的读取位点或写入位点,再根据页面显示的位点类型填写调整位点。
确认值和影响范围后,单击验证并提交。任务会进入暂停和重新启动过程;任务恢复运行后,再次打开同步位点管理确认位点已更新。
修改同步位点,将会调整日志读取或同步写入的点位,可能导致数据丢失,谨慎操作! 修改任一位点都可能导致数据丢失或源端与目标端数据不一致。请仅在已授权的测试环境,或已完成备份并具备回滚方案的维护窗口执行。已完成增量复制的任务不能重置位点。
附录:预检查项一览表
| 检查项 | 检查内容 |
|---|---|
| 源数据源连接检查 | 检查源数据源网关状态、实例是否可达、用户名及密码准确性。 |
| 目标数据源连接检查 | 检查目标数据源网关状态、实例是否可达、用户名及密码准确性。 |
| 源库权限检查 | 检查源数据库账号权限是否满足要求。 |
| 源数据源和目标数据源版本检查 | 检查源数据源和目标数据源版本是否兼容。 |
| 循环链路检查 | 检查是否存在循环链路。 |
| 源端联邦表可用性校验 | 检查源端联邦表是否可用。 |