SQL Server 迁移同步到 Kafka
NineData 数据复制支持将 SQL Server 的全量数据和增量变更投递到 Kafka。投递格式支持 Canal JSON、Debezium JSON 和 Avro。Debezium JSON 的消息结构请参见Debezium JSON 格式,Avro 编码和 Schema 获取方式请参见Avro Schema。
前提条件
- 已将 SQL Server 源数据源和 Kafka 目标数据源添加至 NineData。如何添加,请参见添加数据源。
- SQL Server 版本为 2022、2019、2017、2016、2014、2012、2008R2、2008 其中之一。
- Kafka 版本为 0.10 或更高版本。
- 源端账号具有待读取对象的读权限。执行增量复制时,源端账号需要所有者权限,且 SQL Server Agent 已启用。
- Kafka 账号具有目标 Topic 的写入权限。选择 Avro 时,Schema Registry 地址可从 NineData 所在网络访问;如 Schema Registry 开启认证,请准备用户名或 API Key 以及密码或 Secret。
使用限制
- 执行全量复制前,请评估源端和 Kafka 集群的性能,并尽量在业务低峰期启动任务。
- 建议同步表具有主键或唯一约束,且列名唯一,以降低重复消息和下游去重成本。
- 本文附录不定义固定的 Avro 字段结构。Avro 消费端应从任务配置的 Confluent Schema Registry 获取对应 Schema 后再解析消息。
操作步骤
登录 NineData 控制台。
在左侧导航栏单击数据复制 > 数据复制。
在数据复制页面,单击右上角的创建复制。
在数据源与目标页签,按照下表进行配置,并单击下一步。
参数 说明 任务名称 输入数据同步任务的名称,为了方便后续查找和管理,请尽量使用有意义的名称。最多支持 64 个字符。 源数据源 同步对象所在的数据源。 目标数据源 接收同步对象的数据源。 Kafka Topic 选择目标 Kafka Topic(主题),源数据源中的数据将写入到该指定 Topic 中。 投递分区 将数据投递到一个 Topic 中时,可以指定这些数据要投递到 Topic 中的哪个分区。 - 全部投递到 Partition 0:将所有数据投递到默认的分区 0。
- 按【库名 + 表名】的 Hash 值散列投递到不同 Partition:将数据散列分配到不同的分区中,系统会使用库名和表名的哈希值来计算目标数据投递到哪个分区,以确保散列投递过程中,同一个表中的数据被投递到同一分区。
投递数据格式 选择投递到 Kafka 的消息格式。 - Canal JSON:以 Canal JSON 格式投递消息。
- Avro:以 Avro 格式投递消息,并通过 Confluent Schema Registry 管理消息 Schema。
Confluent Schema Registry服务地址 选择 Avro 时必填。输入 Confluent Schema Registry 服务地址,例如 <schema-registry-host>:<port>。用户名或API-KEY 选择 Avro 时按需填写 Schema Registry 用户名或 API Key。 密码或Secret 选择 Avro 时按需填写 Schema Registry 密码或 Secret。 目标对象命名规则 选择对象名称从源端迁移到目标端后的大小写转换规则。 - 全部转小写:无论源端的命名规则如何,目标端的命名规则全部为小写。
- 保持与源一致:沿用源端的命名规则。
- 全部转大写:无论源端的命名规则如何,目标端的命名规则全部为大写。
复制类型 选择复制类型。 - 全量复制:同步源数据源的所有对象和数据,即全量数据复制。右侧的开关为周期性全量复制的开关,更多信息,请参见周期性全量复制。
- 增量复制:在全量同步完成后,基于源数据源的日志进行增量同步。
增量开始时间 复制类型仅为增量复制时需要选择。 - 从启动时间开始:以当前复制任务开始时间为基准,进行增量复制。
- 自定义时间:选择增量复制开始的时间点,您可以根据您的业务所在地域按需选择时区。如果将时间点配置为当前复制任务开始前,则如果该时间段内有 DDL 操作,复制任务将失败。
复制规格 复制任务的规格,规格越大复制的速率越高,将鼠标悬浮于  图标上即可查看每个规格对应的速率和配置信息。如果先配置数据复制任务再购买资源,可以在此选择需要的规格;如果先购买资源再配置任务,系统会选中购买资源时指定的规格,且无法在任务配置中变更。
目标表存量数据处理策略(选中全量复制时需要选择) - 预检查报错并停止任务:预检查阶段检测到目标表中存在数据时,停止任务。
- 忽略目标存量数据,追加写入:预检查阶段检测到目标表中存在数据时,忽略该部分数据,追加写入其他数据。
- 清空目标存量数据,重新写入:预检查阶段检测到目标表中存在数据时,删除该部分数据,重新写入。
目标表增量数据冲突处理策略(选中增量复制时需要选择) - 运行时报错:增量复制过程中遇到目标数据已存在则报错,等待人工介入处理。
- 不更新目标数据:增量复制过程中遇到目标数据已存在则不写入,并继续后续任务。
- 更新目标数据:增量复制过程中遇到目标数据已存在则覆盖写入目标数据。
在选择复制对象页签,配置下列参数,然后单击下一步。
参数 说明 复制对象 选择需要复制的内容,您可以选择全部实例复制源库所有内容,也可以选择自定义对象,在源对象列表中选中需要复制的内容,单击>添加到右侧目标对象列表。 如果您需要创建多条相同复制对象的复制链路,可以创建一个配置文件,在新建任务的时候导入即可。单击右上角的导入配置,再单击下载模板,将配置文件模版下载到本地,编辑完成后单击上传文件上传该配置文件即可实现批量导入。字段和示例请参见导入复制对象配置模板。配置文件说明:
参数 说明 示例 source_table_name需同步的源表名。填写源数据源中实际存在的表名。 example_tbl_nametarget_table_name接收同步对象的目标表名。 example_tbl_namesource_database_name需同步的对象所在的源库名。 test_dbtarget_database_name接收同步对象的目标库名。 test_db_bakcolumn_list需要同步的字段列表。 ["col1", "clo2", "col3"]extra_configuration额外配置的 JSON 字符串。 column_rules用于配置字段映射与取值规则,其中column_name为源列名,target_column_name为目标列名,target_column_type为目标列类型,column_value为字段值;filter_condition用于配置行级过滤条件。{"extra_config": {"column_rules": [...]}}提示以下 JSON 表示下载的 Excel 模板中的两行示例数据。实际上传时,请保留 Excel 模板的列名,并将
extra_configuration单元格填写为 JSON 字符串;以下代码块不是可直接上传的 JSON 文件。[
{
"source_table_name": "example_tbl_name",
"target_table_name": "example_tbl_name",
"source_database_name": "test_db",
"target_database_name": "test_db_bak",
"column_list": ["col1", "clo2", "col3"],
"extra_configuration": {
"extra_config": {
"column_rules": [
{
"column_name": "example_column_name",
"target_column_name": "example_target_column_name",
"target_column_type": "int",
"column_value": "current_timestamp()"
},
{
"column_name": "example_column_name",
"target_column_name": "example_target_column_name",
"target_column_type": "int"
}
],
"filter_condition": "example_condition_expression"
}
}
},
{
"source_table_name": "example_order_tbl",
"target_table_name": "example_order_tbl",
"source_database_name": "test_db",
"target_database_name": "test_db_bak",
"column_list": ["col1", "clo2", "col3"],
"extra_configuration": {
"extra_config": {
"column_rules": [
{
"column_name": "example_column_name",
"target_column_name": "example_target_column_name",
"target_column_type": "int",
"column_value": "current_timestamp()"
},
{
"column_name": "example_column_name",
"target_column_name": "example_target_column_name",
"target_column_type": "int"
}
],
"filter_condition": "example_condition_expression"
}
}
}
]在配置映射页签,可以单独配置需要复制到 Kafka 的每个列,默认情况下将复制所选表的全部列。如果在配置映射阶段,源和目标数据源中有更新,可以单击页面右上角的刷新元数据按钮,重新获取源和目标数据源的信息。配置完成后,单击保存并预检查。
在预检查页签等待系统完成预检查。预检查通过后,在复制任务列表中打开已保存任务的详情页并启动任务。
您可以勾选开启数据一致性对比。在同步任务完成后,自动开启基于源数据源的数据一致性对比,保证两端数据一致。根据您选择的复制类型,开启数据一致性对比的启动时机如下:
- 全量复制:全量复制完成后启动。
- 全量复制+增量复制、增量复制:当增量数据首次和源数据源一致且延迟为 0 秒时启动。您可以单击查看详情,在复制详情页面中查看同步延迟。
如果预检查未通过,需要单击目标检查项右侧操作列的详情,排查失败的原因,手动修复后单击重新检查重新执行预检查,直到通过。
检查结果为警告的检查项,可视具体情况修复或忽略。
复制任务启动后,您可以进行以下操作:
单击查看详情查看同步任务各个阶段的执行情况。
- 单击返回列表可以返回数据复制任务列表页面。
修改增量同步位点
对于复制类型中包含增量复制且任务详情提供位点管理的任务,可以查看并修改同步位点。可用的位点类型和输入格式由当前数据源及复制链路决定,以页面显示为准;如果位点显示为 - 或位点类型没有可选项,则当前任务没有可供修改的位点。
该功能用于特定运维场景:重新指定增量任务的日志读取位置或同步写入位置。读取位点控制任务从源端哪个位置继续读取,写入位点控制任务从哪个位置继续处理同步写入;提交后任务会暂停并重新启动,使新的位点生效。
在复制任务列表中,单击目标任务的任务 ID,进入任务详情。
单击增量复制页签,然后单击同步位点管理,查看当前的读取位点和写入位点。
单击修改位点。在位点类型中选择要调整的读取位点或写入位点,再根据页面显示的位点类型填写调整位点。
确认值和影响范围后,单击验证并提交。任务会进入暂停和重新启动过程;任务恢复运行后,再次打开同步位点管理确认位点已更新。
修改同步位点,将会调整日志读取或同步写入的点位,可能导致数据丢失,谨慎操作! 修改任一位点都可能导致数据丢失或源端与目标端数据不一致。请仅在已授权的测试环境,或已完成备份并具备回滚方案的维护窗口执行。已完成增量复制的任务不能重置位点。
Kafka 投递设置补充
创建复制任务时,可以将任务中的复制对象写入同一个 Topic,也可以为每张表分别使用一个 Topic。共用 Topic 时,通过Kafka Topic选择目标 Topic;按表分配 Topic 时,系统为每张表生成一个 Topic,页面不显示共用 Topic 选择器和投递分区设置。
按表分配时,Topic 名称由 tableTopicPrefix、源数据库名和源表名依次以点号连接,格式为 tableTopicPrefix.<databaseName>.<tableName>。例如,tableTopicPrefix 为 ninedata 时,Topic 名称格式为 ninedata.<databaseName>.<tableName>。
共用 Topic 时,可以通过投递分区选择分区策略:
- 全部投递到 Partition 0:将消息投递到 Partition 0。
- 按【库名 + 表名】的 Hash 值散列投递到不同 Partition:按库名和表名的 Hash 值散列到不同 Partition。
- 按【表名+主键值】的Hash值散列投递到不同 Partition:按表名和主键值的 Hash 值散列到不同 Partition。
通过投递数据格式选择投递数据格式,支持 Canal JSON、Debezium JSON 和 Avro。Debezium JSON 消息结构请参见Debezium JSON 格式;Avro 消息编码和 Schema 获取方式请参见Avro Schema。
查看同步结果
登录 NineData 控制台。
在左侧导航栏单击数据复制 > 数据复制。
在数据复制页面单击目标同步任务的 ID,打开复制详情页面,页面说明如下。
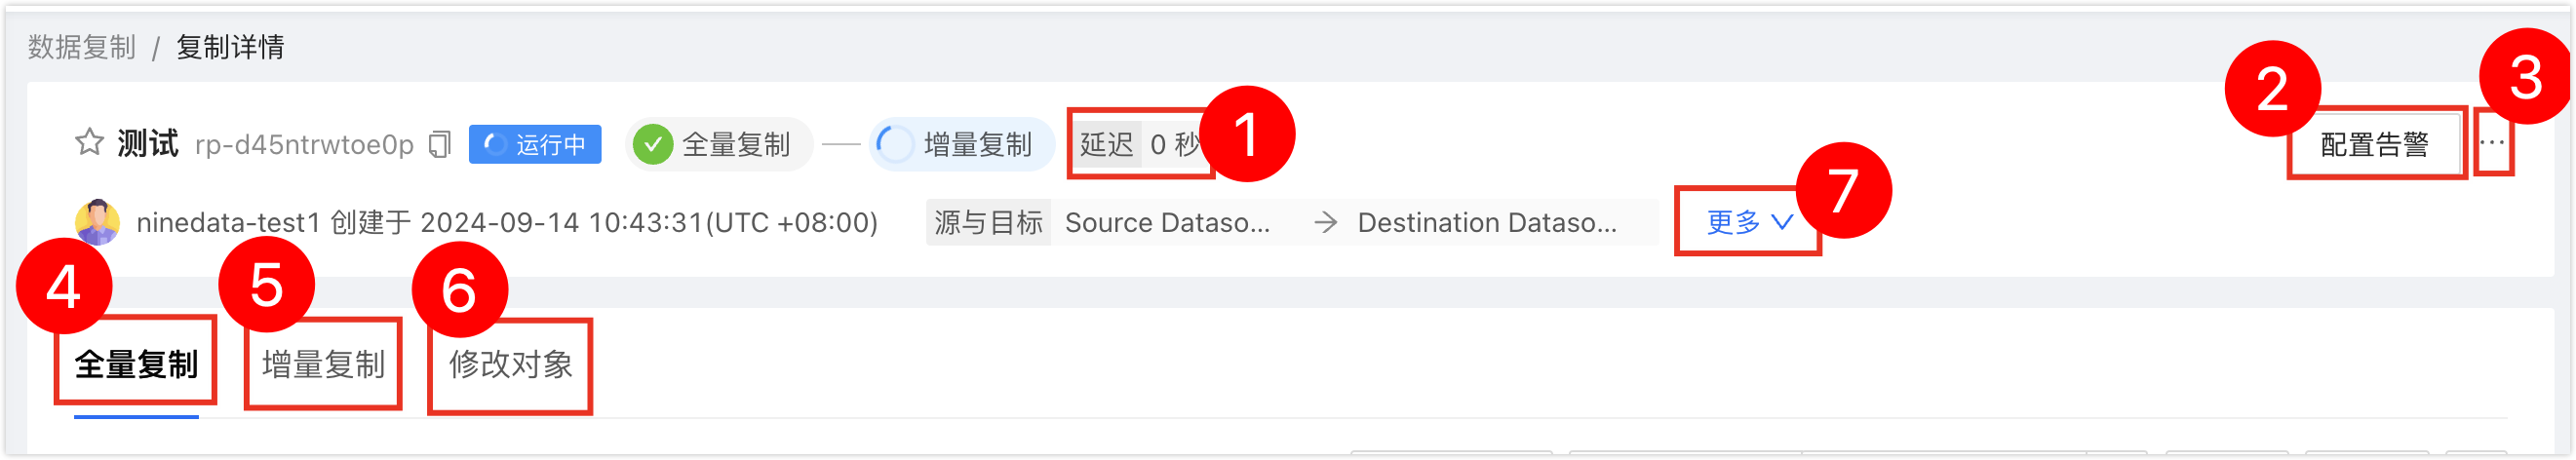
序号 功能 说明 1 同步延迟 源数据源和目标数据源之间的数据同步延迟,0 秒表示两端之间没有延迟,即 Kafka 端的数据目前已追平源端。 2 配置告警 配置告警后,系统会在任务失败时通过您选择的方式通知您。更多信息,请参见运维监控简介。 3 更多 - 暂停:暂停任务,仅状态为运行中的任务可选。
- 终止:结束未完成或监听中(即增量同步中)的任务,终止任务后无法重启任务,请谨慎操作。
- 删除:删除任务,任务删除后无法恢复,请谨慎操作。
4 全量复制(包含全量复制的场景下显示) 展示全量复制的进度和详细信息。 - 单击页面右侧的监控:查看全量复制过程中的各监控指标。全量复制过程中,还可以单击监控指标页面右侧的限流设置,限制每秒写入到目标数据源的速率。单位为 MB/S。
- 单击页面右侧的日志:查看全量复制的执行日志。
- 单击页面右侧的
 图标:查看最新的信息。
5 增量复制(包含增量复制的场景下显示) 展示增量复制的各项监控指标。 - 单击页面右侧的限流设置:限制每秒写入到目标数据源的速率。单位为行/秒。
- 单击页面右侧的日志:查看增量复制的执行日志。
- 单击页面右侧的图标:查看最新的信息。
6 修改对象 展示同步对象的修改记录。 - 单击页面右侧的修改同步对象,可对同步对象进行配置。
- 单击页面右侧的图标:查看最新的信息。
7 展开 展示当前复制任务的详细信息,包括复制类型、复制对象、开始时间等。
Debezium JSON 数据格式说明
每条消息采用 Debezium JSON Envelope 格式,顶层包含 schema 和 payload。schema 描述消息字段结构,payload 携带变更数据和源端元数据。
| 字段 | 类型 | 说明 |
|---|---|---|
schema | JSON | 描述 payload 中字段及其结构。 |
payload | JSON | 包含行镜像、操作类型和源端元数据。 |
payload.before | JSON | 变更前的行数据;INSERT 或读取快照时为 null,UPDATE 和 DELETE 时包含变更前的行数据。 |
payload.after | JSON | 变更后的行数据;INSERT、UPDATE 或读取快照时包含变更后的行数据,DELETE 时为 null。 |
payload.source | JSON | 源端事件元数据;具体字段随源数据源类型和事件变化。 |
payload.op | STRING | 操作类型:r 表示读取快照,c 表示 INSERT,u 表示 UPDATE,d 表示 DELETE。 |
payload.ts_ms | LONG | 时间戳,单位为毫秒。 |
消息 Schema 和 payload.source 中的字段会随源数据源及复制对象而变化;消费端应按收到的消息结构解析,不要假定所有源端都使用相同的来源字段。
Avro Schema 定义
Avro 消息使用 Confluent Schema Registry 管理 Schema。Kafka 消息的 value 开头 5 个字节是 Schema 标识头:第 1 个字节固定为 0x00,后 4 个字节按大端序记录 Schema ID。标识头之后是 Avro Binary 编码的数据。
消费端读取 Schema ID 后,从任务配置的 Schema Registry 获取对应 Schema,再使用该 Schema 解码后续的 Avro Binary 数据。Schema 中的记录字段和类型取决于源数据源、表结构和列定义;消费端应以 Registry 返回的 Schema 为准,不要假定存在适用于所有源表的固定字段清单。
MySQL 源端的 Schema 字段示例请参见 MySQL 迁移同步到 Kafka:Avro Schema 定义。该示例中的字段映射适用于 MySQL 源端;其他源端应使用 Registry 为任务返回的 Schema。
使用 Avro 前,需要配置 Confluent Schema Registry 地址;Registry 启用认证时,还需要填写相应的用户名或 API Key,以及密码或 Secret。